Claude Code を午前中から走らせて、昼休みに戻ってきたら、同じエージェントが数時間前に自分で書いたコードを「初めて見ました」と言い出す — こういう体験に心当たりがあるなら、本稿は役に立ちます。
2024 年までの LLM 開発の中心は プロンプトエンジニアリング、つまり「どう書けば LLM にうまく仕事を頼めるか」の最適化でした。
2025 年 9 月、Anthropic は Effective context engineering for AI agents を公開し、新しい概念を打ち出しました。
Context Engineering — 複数ターン・長期にわたるエージェント運用で、何をコンテキストに置き、何を捨てるかを設計する反復プロセス
Claude Code や MulmoTerminal のような長時間動くエージェントでは、1 ターンの指示文最適化ではなく、セッション全体でのコンテキスト設計が勝負になります。
本稿では、Prompt Engineering との違い、長時間セッションで起きる問題(Context Rot)、そして推奨される 5 つの技法を、実例とともに整理します。
Prompt Engineering と Context Engineering の違い
Prompt Engineering (従来)
- 対象: 1 ターンのプロンプト
- 目標: このプロンプトで、この回答を引き出す
- ツール: Few-shot example、Chain of thought、System prompt の最適化
- 評価: 回答の品質
Context Engineering (新しい概念)
- 対象: セッション全体の文脈状態
- 目標: この 100 ターンを通して、エージェントが一貫して有能に動く
- ツール: Compaction、外部メモリ、Sub-agents、動的ロード
- 評価: 長時間動作時のタスク達成率
プロンプト設計は 1 枚のポスター制作、コンテキスト設計は美術館の順路設計 — 時間軸と空間が全く違います。
Anthropic の表現を借りると:
what configuration of context is most likely to generate our model’s desired behavior?
「どういう文脈の配置が、我々の望む挙動を引き出しやすいか」。これが Context Engineering の問いです。
Context Rot — 長文脈は性能を下げる
現象
LLM のコンテキスト窓を大きく埋めるほど、精度は下がります。これを Context Rot と呼びます。
- 10K トークンの文脈で精度 95%
- 100K トークンの文脈で精度 85%
- 200K トークンの文脈で精度 70%
公称 1M〜2M トークンのモデルでも、実運用レンジは 100-500K というのが 2026 年の現実です。
原因
- Transformer の attention は O(n²) のコストで積み上がる
- 長文脈になるほど「どこを見るべきか」が散漫になる
- 学習時のデータ分布が、極端な長文脈では薄い
Context Rot の実感
Claude Code や Codex を長時間使っていて、
- セッション開始時は賢かったのに、2 時間後に忘れっぽくなる
- 「さっき言った X を忘れている」が増える
- トークン使用量が 150K を超えると、品質が目に見えて落ちる
これはモデルの劣化ではなく、Context Rot です。
Context Engineering の 5 技法
技法 1: Compaction(圧縮)
目標: メッセージ履歴を要約して、新しいコンテキストで続ける。
長いメッセージ履歴 → 要約 LLM → 要約 → 新しいセッションに引き渡し保持すべきもの:
- 設計上の重要な決定
- 未解決のバグ・課題
- ユーザーの明示的な指示
- ドメイン固有の制約
捨てるべきもの:
- 中間ツール呼び出しの詳細
- 試行錯誤の失敗ログ
- 同じ情報の重複
Claude Code / MulmoTerminal のセッションでは、自動 compaction が走ります。コンテキストが閾値を超えると、過去の履歴を要約して、新しい session を begin する。
技法 2: Structured Note-Taking(構造化メモ)
目標: エージェント自身に、進捗や依存関係をファイルに書き出させる。
Agent: 作業中にメモを書き出す → ファイル → 次ターンで読み直す例: Claude Code の plans/ ディレクトリ
- Agent が長い作業を始めるとき、まず
plans/fix-xxx.mdを書く - 「何をするか」「現時点までに何をしたか」「次に何をするか」
- Compaction で履歴が消えても、plan ファイルは残る
これは人間の「ノートを取る」のソフトウェア版 です。Think out loud を外部化する。
技法 3: Sub-agent Architectures(サブエージェント構成)
目標: 専門的なサブエージェントが仕事をして、統括エージェントに凝縮した結果だけを返す。
統括 (orchestrator)
├── sub-agent A (詳細調査、10,000 トークン使う)
├── sub-agent B (別の調査、15,000 トークン使う)
└── sub-agent C (さらに別の調査、8,000 トークン使う)
     ↓
     それぞれ 1,000-2,000 トークンに要約して orchestrator に返す
Orchestrator から見ると、入力は全部で 5,000 トークンに収まります。実際には裏で 33,000 トークンの詳細調査が走っています。
Anthropic の Research 機能(Multi-agent research system)はこの構成を採用しており、Building effective agents の Orchestrator-Workers パターンに相当します。
技法 4: Just-in-Time Retrieval(動的ロード)
目標: 全データを最初から入れずに、識別子だけ持って、必要なときに取る。
軽量な識別子 (ファイル名、ID) をコンテキストに保持
    ↓
エージェントが必要になったら、tool call でロード
    ↓
使い終わったら忘れる例: Claude Code の glob と read
- プロジェクトの全ファイルを最初に読み込むのではない
- ファイル名の一覧だけ知っている
- 「X という関数を直したい」と言われたら、関連ファイルを
grep→readする
これにより、文脈窓を圧迫せず、必要な情報には到達できる状態を保ちます。
技法 5: Hybrid Strategy(ハイブリッド)
実運用では、上記の 4 技法を組み合わせます。
Claude Code の実装例
- CLAUDE.md はプロジェクトのルールや優先度の高い情報として最初に読ませる
- ファイル階層は読み込まず
globで動的に探索させる - コードは必要な分だけ
readで取り寄せる - 長い実行は
plans/に書き出して compaction を跨がせる - 並列調査は sub-agent (Task tool) に委ねて詳細作業を外に出す
これが Anthropic 公式の推奨する “do the simplest thing that works” の実装形になります。
MulmoTerminal での Context Engineering
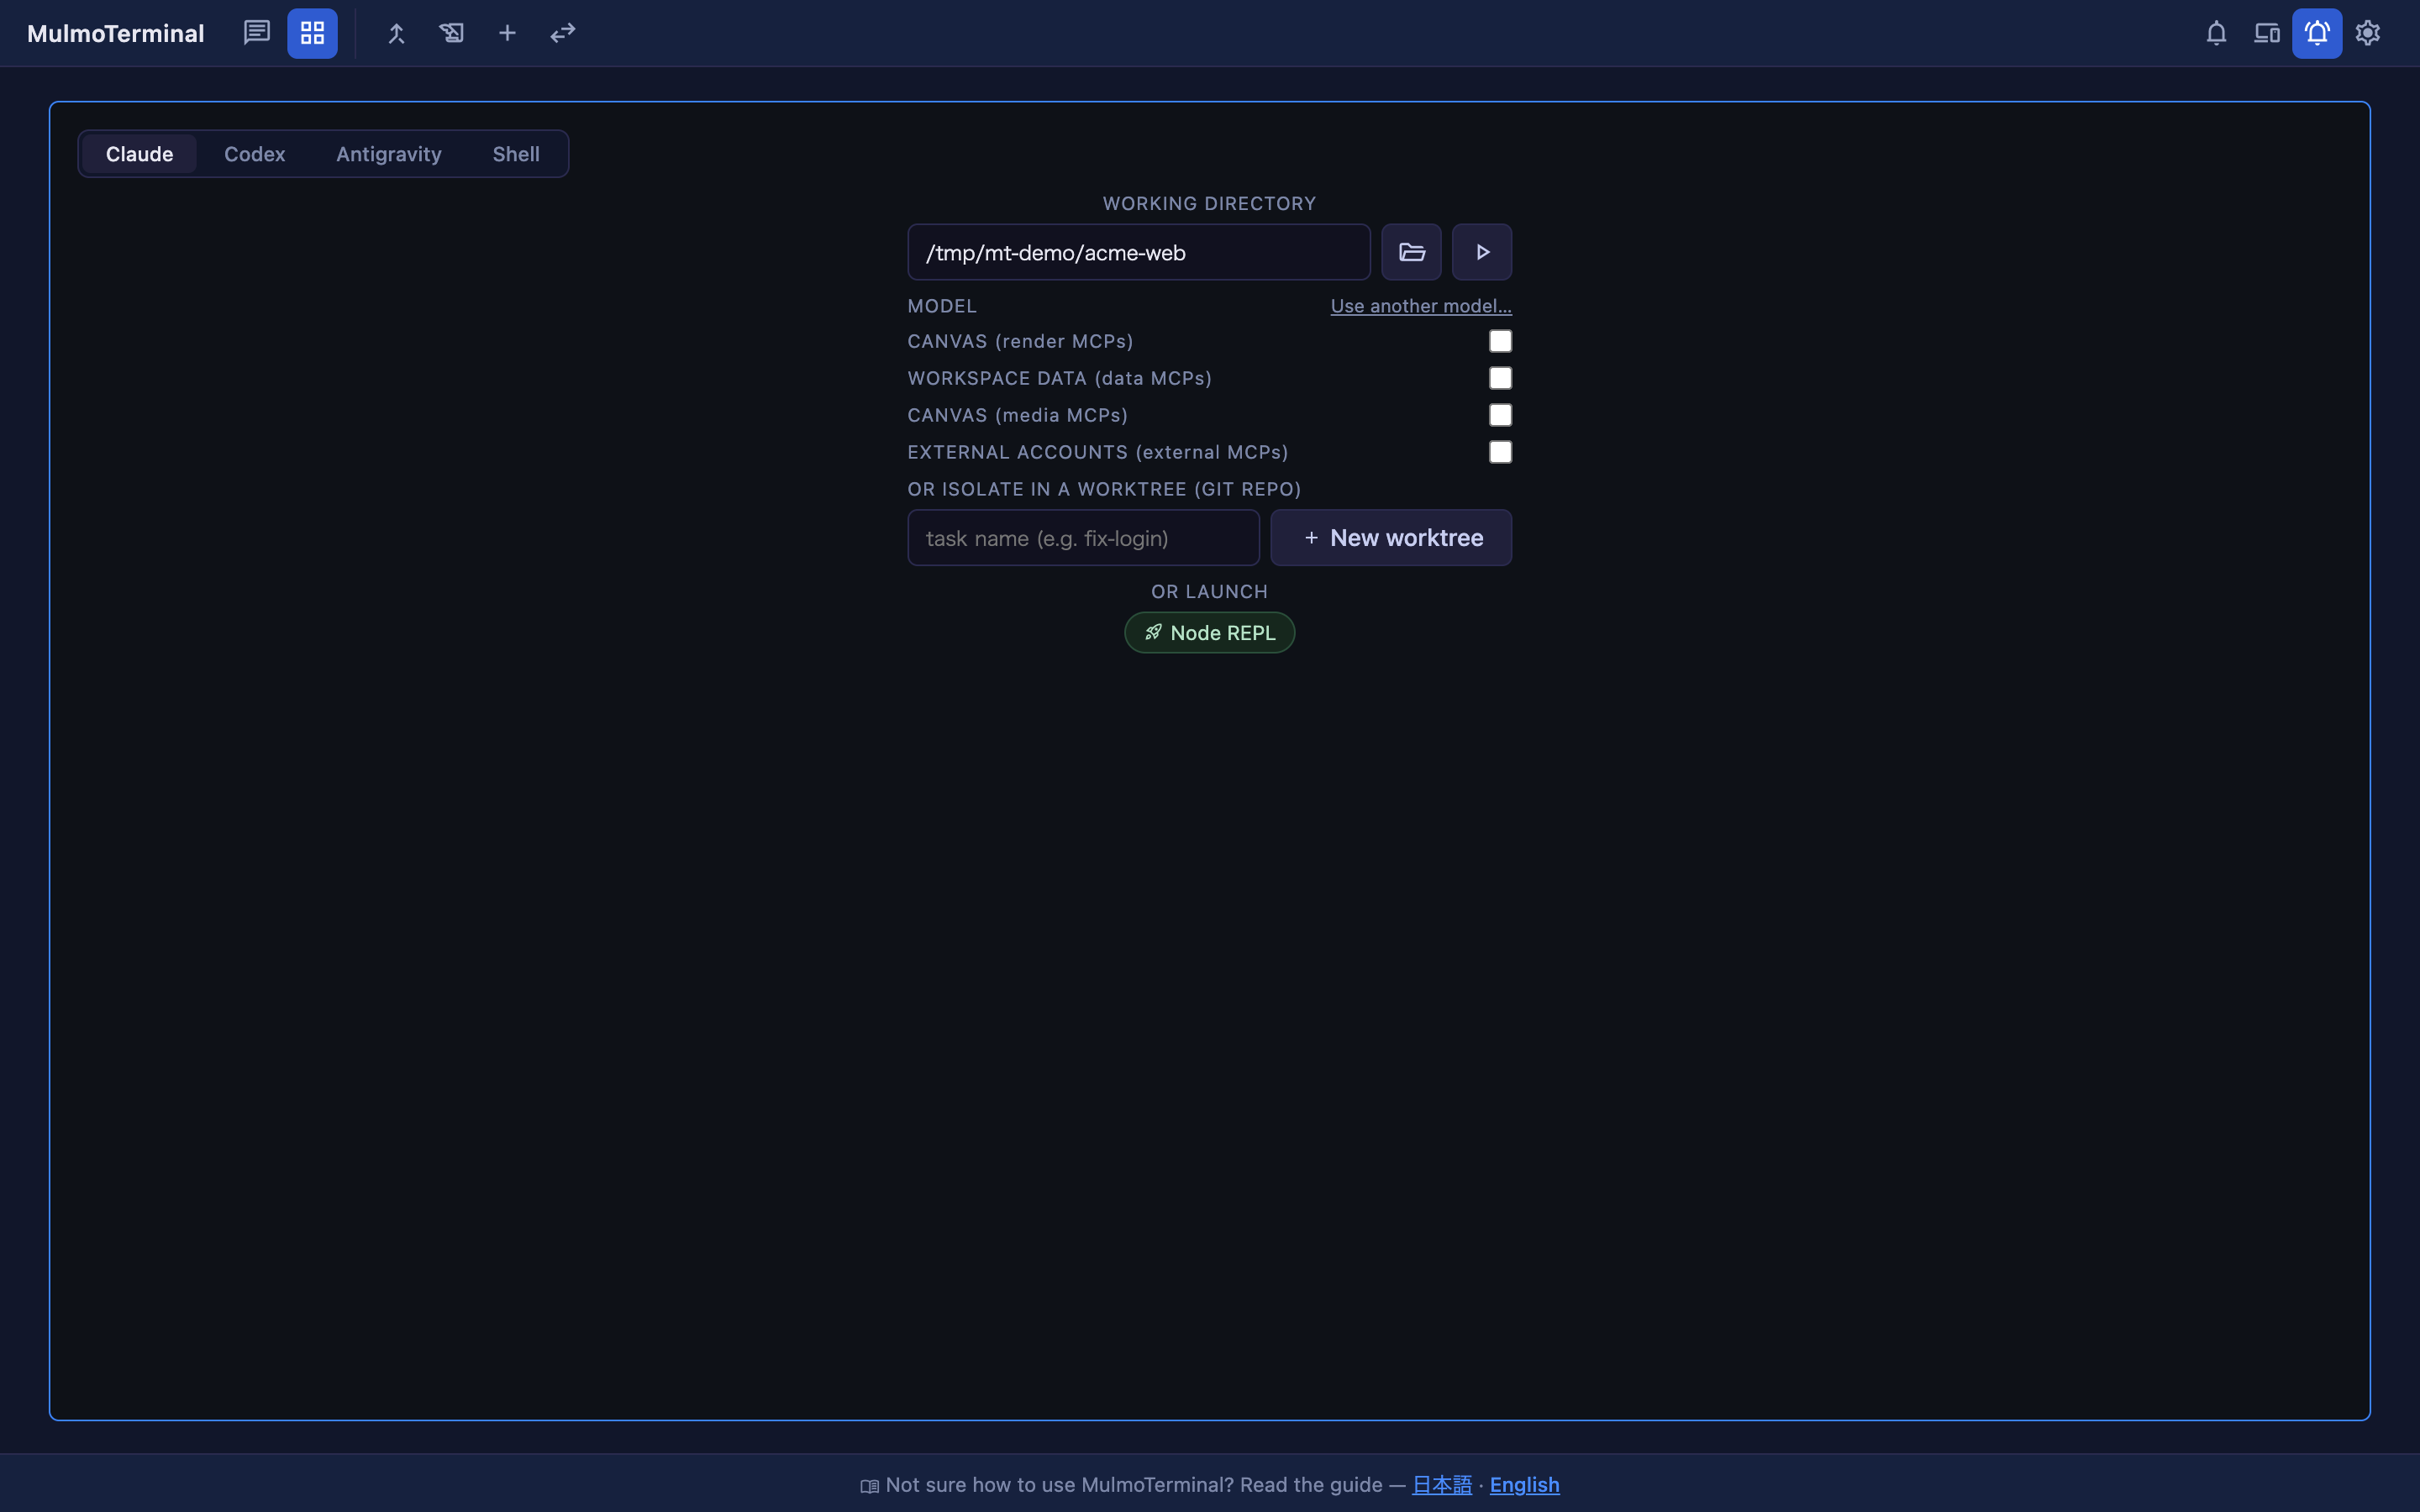
MulmoTerminal は長時間動くエージェントのコックピットです。Context Engineering の技法が内蔵されています。
Cockpit Roster(1 行サマリー)
- 拡大中のセルの横に、他 8 セルの状況を 1 行ずつ表示
- Compaction を人間側に適用した形: 「全セッションの詳細を見る」ではなく「要約で把握する」
Decision Digest
- セッション中にエージェントから出た質問と、ユーザーが答えた選択を自動で蓄積する
~/.mulmoterminal/decisions/<project>.mdに書き出す- 次のセッションでエージェントが過去の決定を読み、同じ質問を繰り返さずに済む
- Structured note-taking を自動化した形になる
Session Memo
- セルヘッダーに「このセルが何のためのものか」を 1 行書ける
- セッションを再開したとき、何をしていたかを即座に思い出せる
- Compaction で履歴が消えても、メモは残る
Round Table
- 複数のエージェントが順番に発言するフォーラム
- Sub-agent architecture の実装:各エージェントが短い発言で、長い内部思考は外に出さない
エンジニアが今日から実践すべきこと
1. CLAUDE.md を書く
まだ書いていないなら、プロジェクトごとに CLAUDE.md を書きます。
- プロジェクトの目的
- アーキテクチャの概要
- コーディング規約
- 禁止事項・優先事項
これだけで、エージェントの精度と一貫性が目に見えて上がります。Claude Code 公式のベストプラクティス に書き方のガイドあり。
2. 長時間セッションは分割する
1 セッションで 10 時間動かすより、2 時間ごとに意図的に区切って compaction するほうが精度が上がります。
3. plans/ ディレクトリを使う
長い作業に入る前に、エージェントに plans/xxx.md を書かせます。進捗・決定・残タスクをここに追記させる形にします。
4. Sub-agent で詳細作業を外に出す
Claude Code の Task tool(または Codex の /task)を使って、詳細作業を sub-agent に委譲し、要約だけを main に返させます。
5. 動的ロードを前提にしたプロジェクト構成
- ファイル名から中身が推測できる命名
- 物語を語るディレクトリ構造
- 全体像を書いた README と、各ディレクトリに置く index
エージェントが glob で探索して到達できる状態にしておきます。
まとめ
- Context Engineering は 2025 年 9 月に Anthropic が提唱した概念、プロンプトエンジニアリングの次
- 長時間動くエージェントでは コンテキスト全体の設計 が勝負
- Context Rot: 文脈を埋めるほど精度は下がる、実運用レンジは 100-500K
- 5 技法: Compaction / Structured note-taking / Sub-agents / Just-in-time retrieval / Hybrid
- MulmoTerminal の cockpit roster / decision digest / session memo はこれらの実装例
- 実践: CLAUDE.md を書く / 長時間を分割 / plans/ を使う / sub-agent で外部化
プロンプトエンジニアリングは「書き方」、Context Engineering は「設計」 です。長期的に重要なのは後者。
関連リンク
- 原文: Effective context engineering for AI agents (Anthropic)
- Anthropic Engineering Blog の歩き方
- 「Building Effective Agents」を実務に落とす
- MCP (Model Context Protocol) 入門
- MulmoTerminal — Claude Code を並列実行するコックピット
- AI エージェント並列化で開発速度 10 倍
Singularity Society はテクノロジー集団として MulmoClaude / MulmoTerminal / MulmoCast を開発しています。エンジニア・起業家向けの実践プログラム BootCamp も運営しています。