エージェントの出来を点数で測るようにしました。50問ほどの課題を解かせて、通った数を数えるだけのものです。
指示を直しては回す、を繰り返します。点数は62から71に上がりました。もう一度直して回すと74。気をよくしてもう一周すると74のままです。次も74、その次は73。
もう一周だけ、と思って続けます。そのころには、最初に何を直したのかを覚えていません。
上がらなくなったのか、たまたま続いているだけなのか、見分けがつきませんでした。
上がっているのか、合わせているのか
もう1つ厄介なことがあります。点数は上がっているのに、実際には良くなっていない場合があります。
評価に使った問題に合わせ込んでしまう形です。失敗した例を見て指示を直す、という作業を繰り返すと、その例に効く指示ができあがります。別の問題では効きません。
自分で回していると、これが分かりません。点数は上がり続けるからです。
分けて測る
Anthropic が公開した手引きに、ここを扱った具体的な決まりがあります。
いちばん効くのは、問題を2つに分けておくことです。直すときに見るのは片方だけにして、もう片方は触りません。
両方上がれば、その変更を残します。片方だけ上がったら、戻します。合わせ込みが起きていれば、見ていないほうは動かないので、そこで分かります。
合わせて2つ。失敗した記録を指示にそのまま貼らないこと。答えがモデルから届く場所に置かないこと。どちらも、見た目の点数だけが上がる経路を塞ぐためのものです。
1周に1つだけ
1回の周回で変える箇所を1つに絞る、という決まりもあります。
2つ変えて点数が上がったとき、どちらが効いたのかは分かりません。片方は効いて、もう片方は足を引っ張っていた、ということもあります。
変えるなら、言い回しを整えるのではなく、原因に当てる。節を書き直す、抜けている決まりを足す、という形です。
止める条件
ここが知りたかった部分です。
2、3周ぶん点数が動かなければ止める、と書かれています。
止まったあとにやることも決まっていて、残っている失敗を原因ごとに分けます。そのうえで、ひとつの修正で稼げる幅が測定のばらつきより小さいなら、指示をいじるのをやめて、問題の数か繰り返しの回数を増やすほうに回します。
伸びなくなったのは指示が悪いからではなく、測り方が粗いからかもしれない、という見方です。
測るものの作り方
回す前の話として、評価そのものの条件も4つ挙がっています。
本番に似ていること。強いモデルや、よく考えさせたときに点数が上がること。いちばん強い設定でも満点に遠いこと。同じものを測ったときのばらつきが小さいこと。
3つ目が意外に効きます。満点近くまで取れてしまう評価では、改善が測れません。どの変更も満点のままなので、効いたかどうかが見えません。
4つ目も同じ理由です。毎回ばらつくなら、点数が動いたのが変更のせいなのか、たまたまなのかが分かりません。
難しい問題の選び方
失敗した例を集めて評価にする、というやり方には落とし穴があります。
いまのモデルが落とした問題ばかりを集めると、そのモデルの苦手の形を測ることになります。本質的に難しい問題を測っているわけではありません。モデルが変わると、評価そのものが意味を失います。
人が見て難しいと判断したから入れる、という選び方が挙げられています。なぜ難しいのかを先に言えること、が条件です。
並べて回す
ループを並列で回すと、周回の数は稼げます。止める条件が決まっていないと、止まらないものが5つになるだけです。
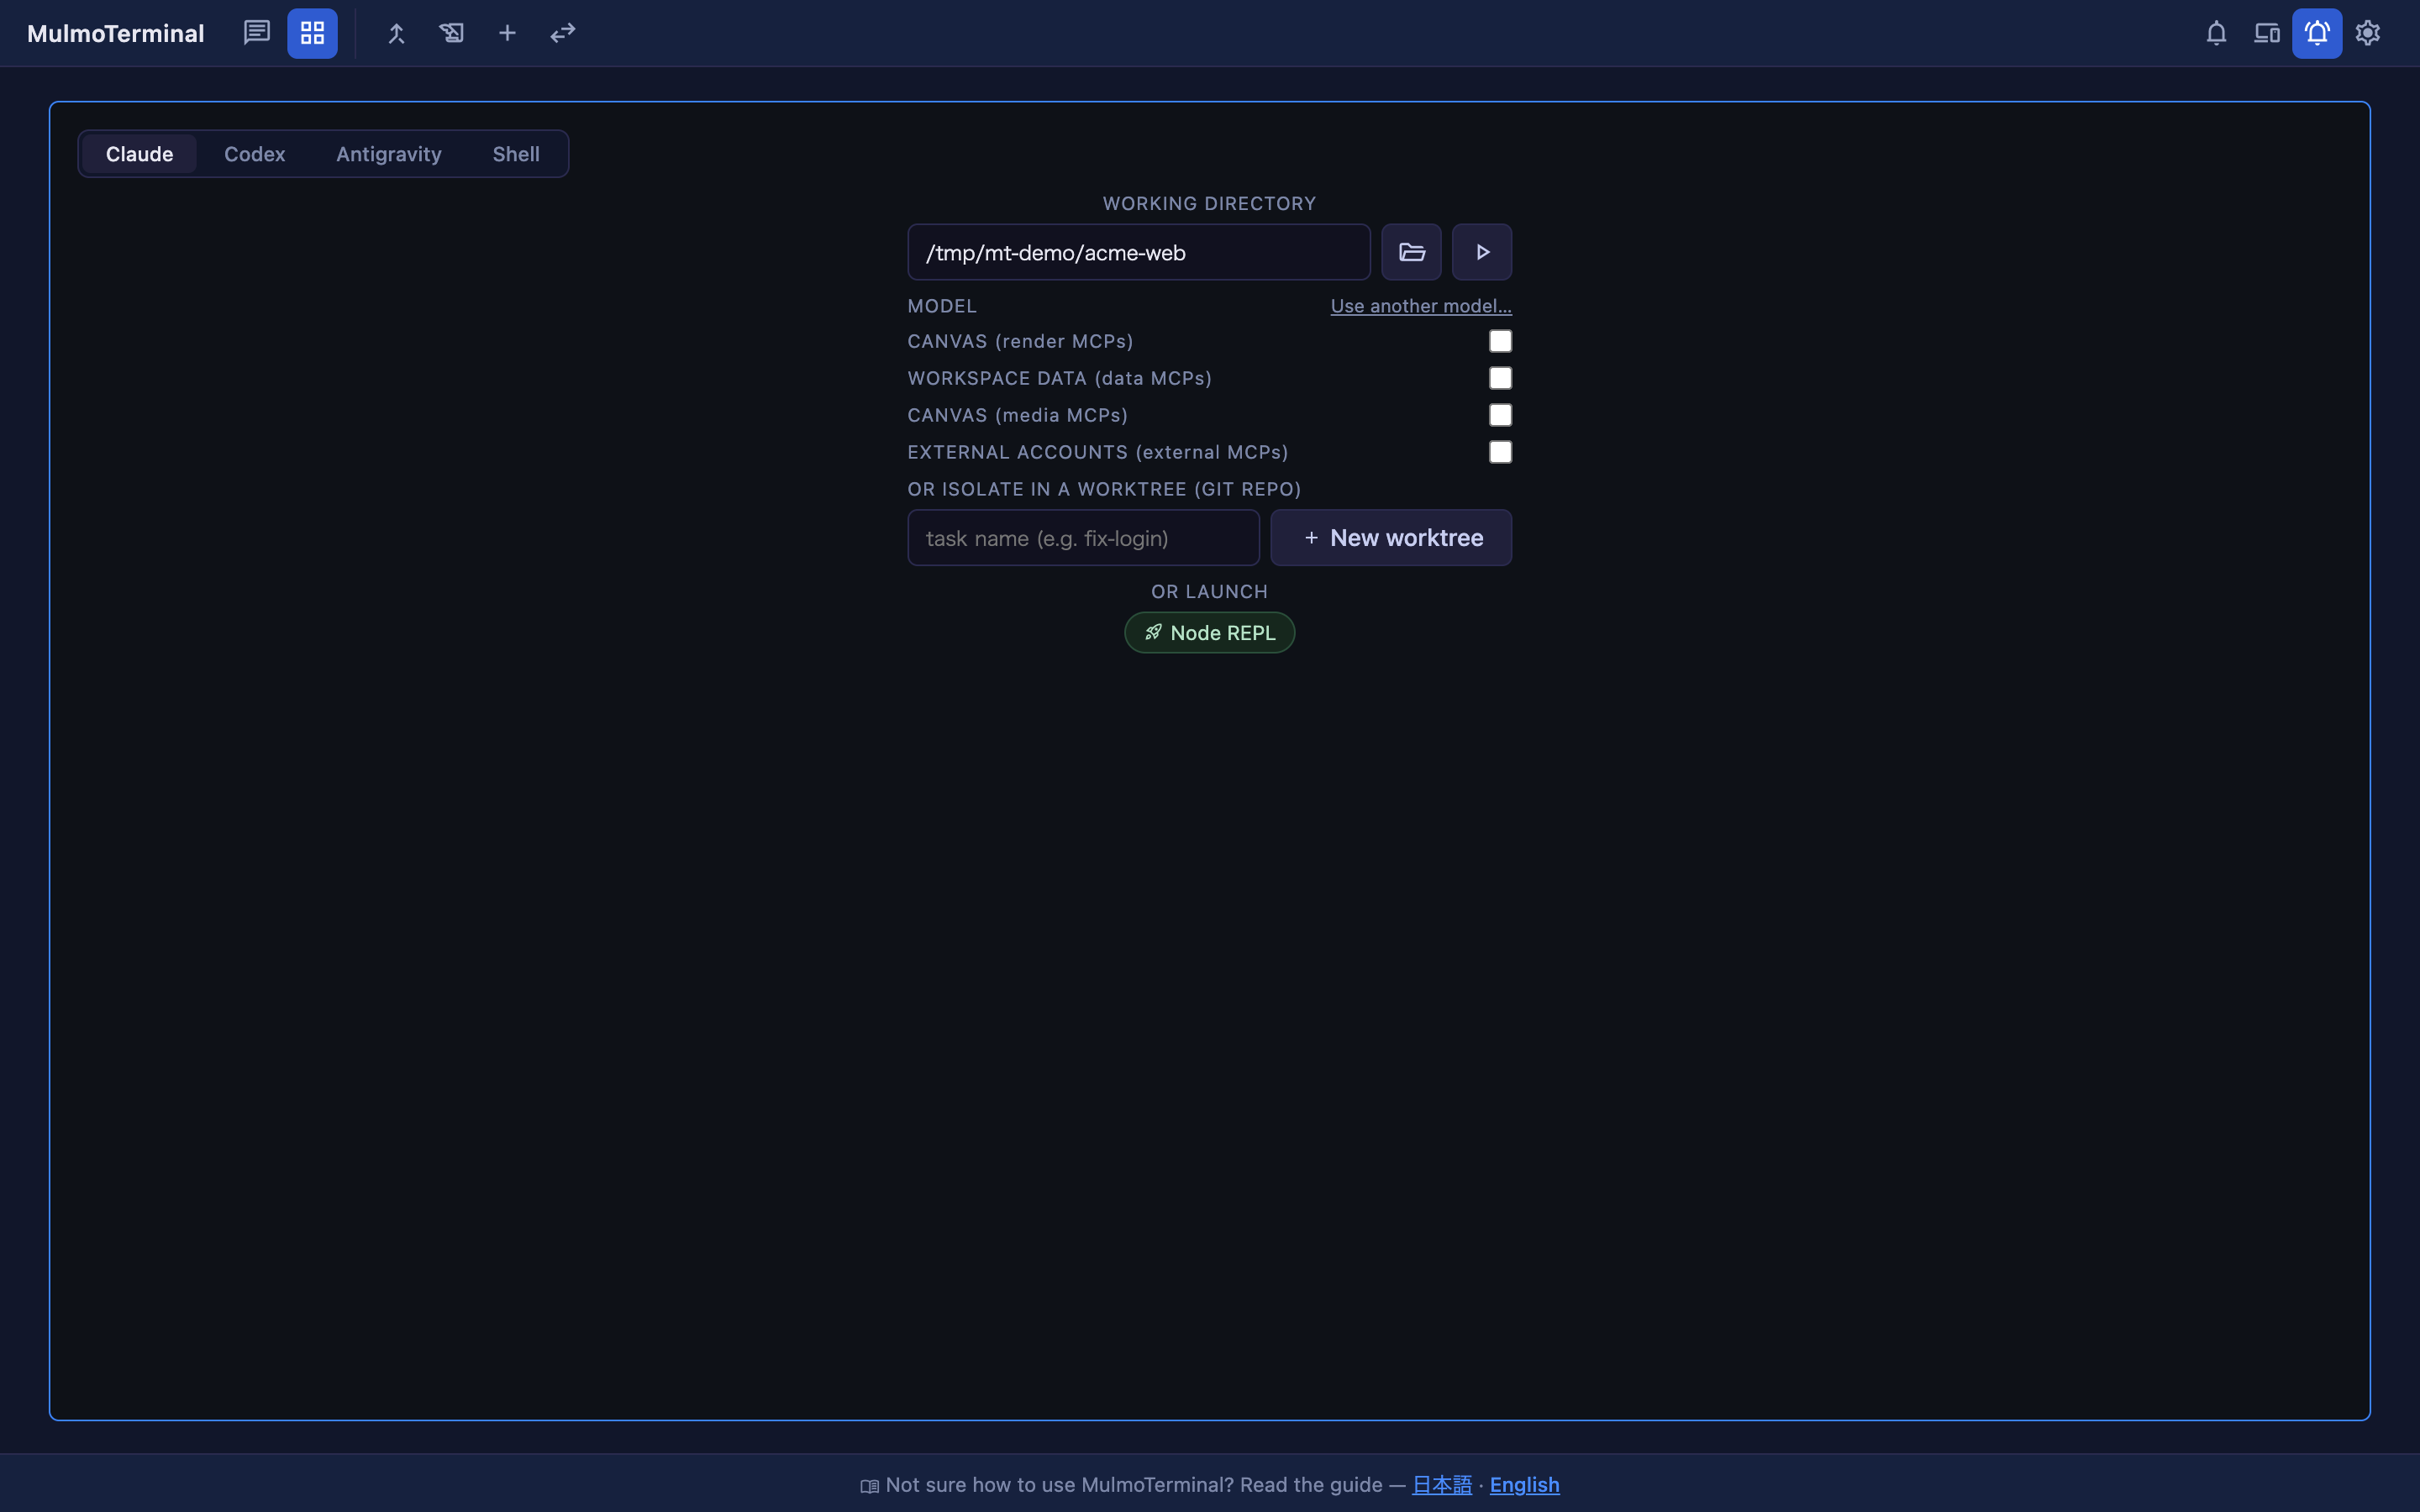
npx mulmoterminal@latestMulmoTerminal は枠ごとに worktree を切るので、並べたループが互いのファイルを踏みません。枠の色で、動いているか人を待っているかは分かります。
ただし、空回りしているかどうかは色では分かりません。点数の記録を見ることになります。止める条件は、外から見張るのではなく、ループの中に書いておくものです。
まとめ
ループを回して良くしていく作業には、止める条件が要ります。無いと、伸びなくなっても回り続けます。
2、3周ぶん動かなければ止める。1周に1つだけ変える。両方の問題で上がったときだけ残す。どれも、自分を騙さないための形です。
- Anthropic の手引き
- MulmoTerminal —
npx mulmoterminal@latest